projetos / um projeto
demo · 2026
nomatch
Uma pergunta: por que esse documento não apareceu na minha busca? Roda inteiro no navegador, com o tokenizer da própria turbopuffer compilado pra WebAssembly.
Visão geral
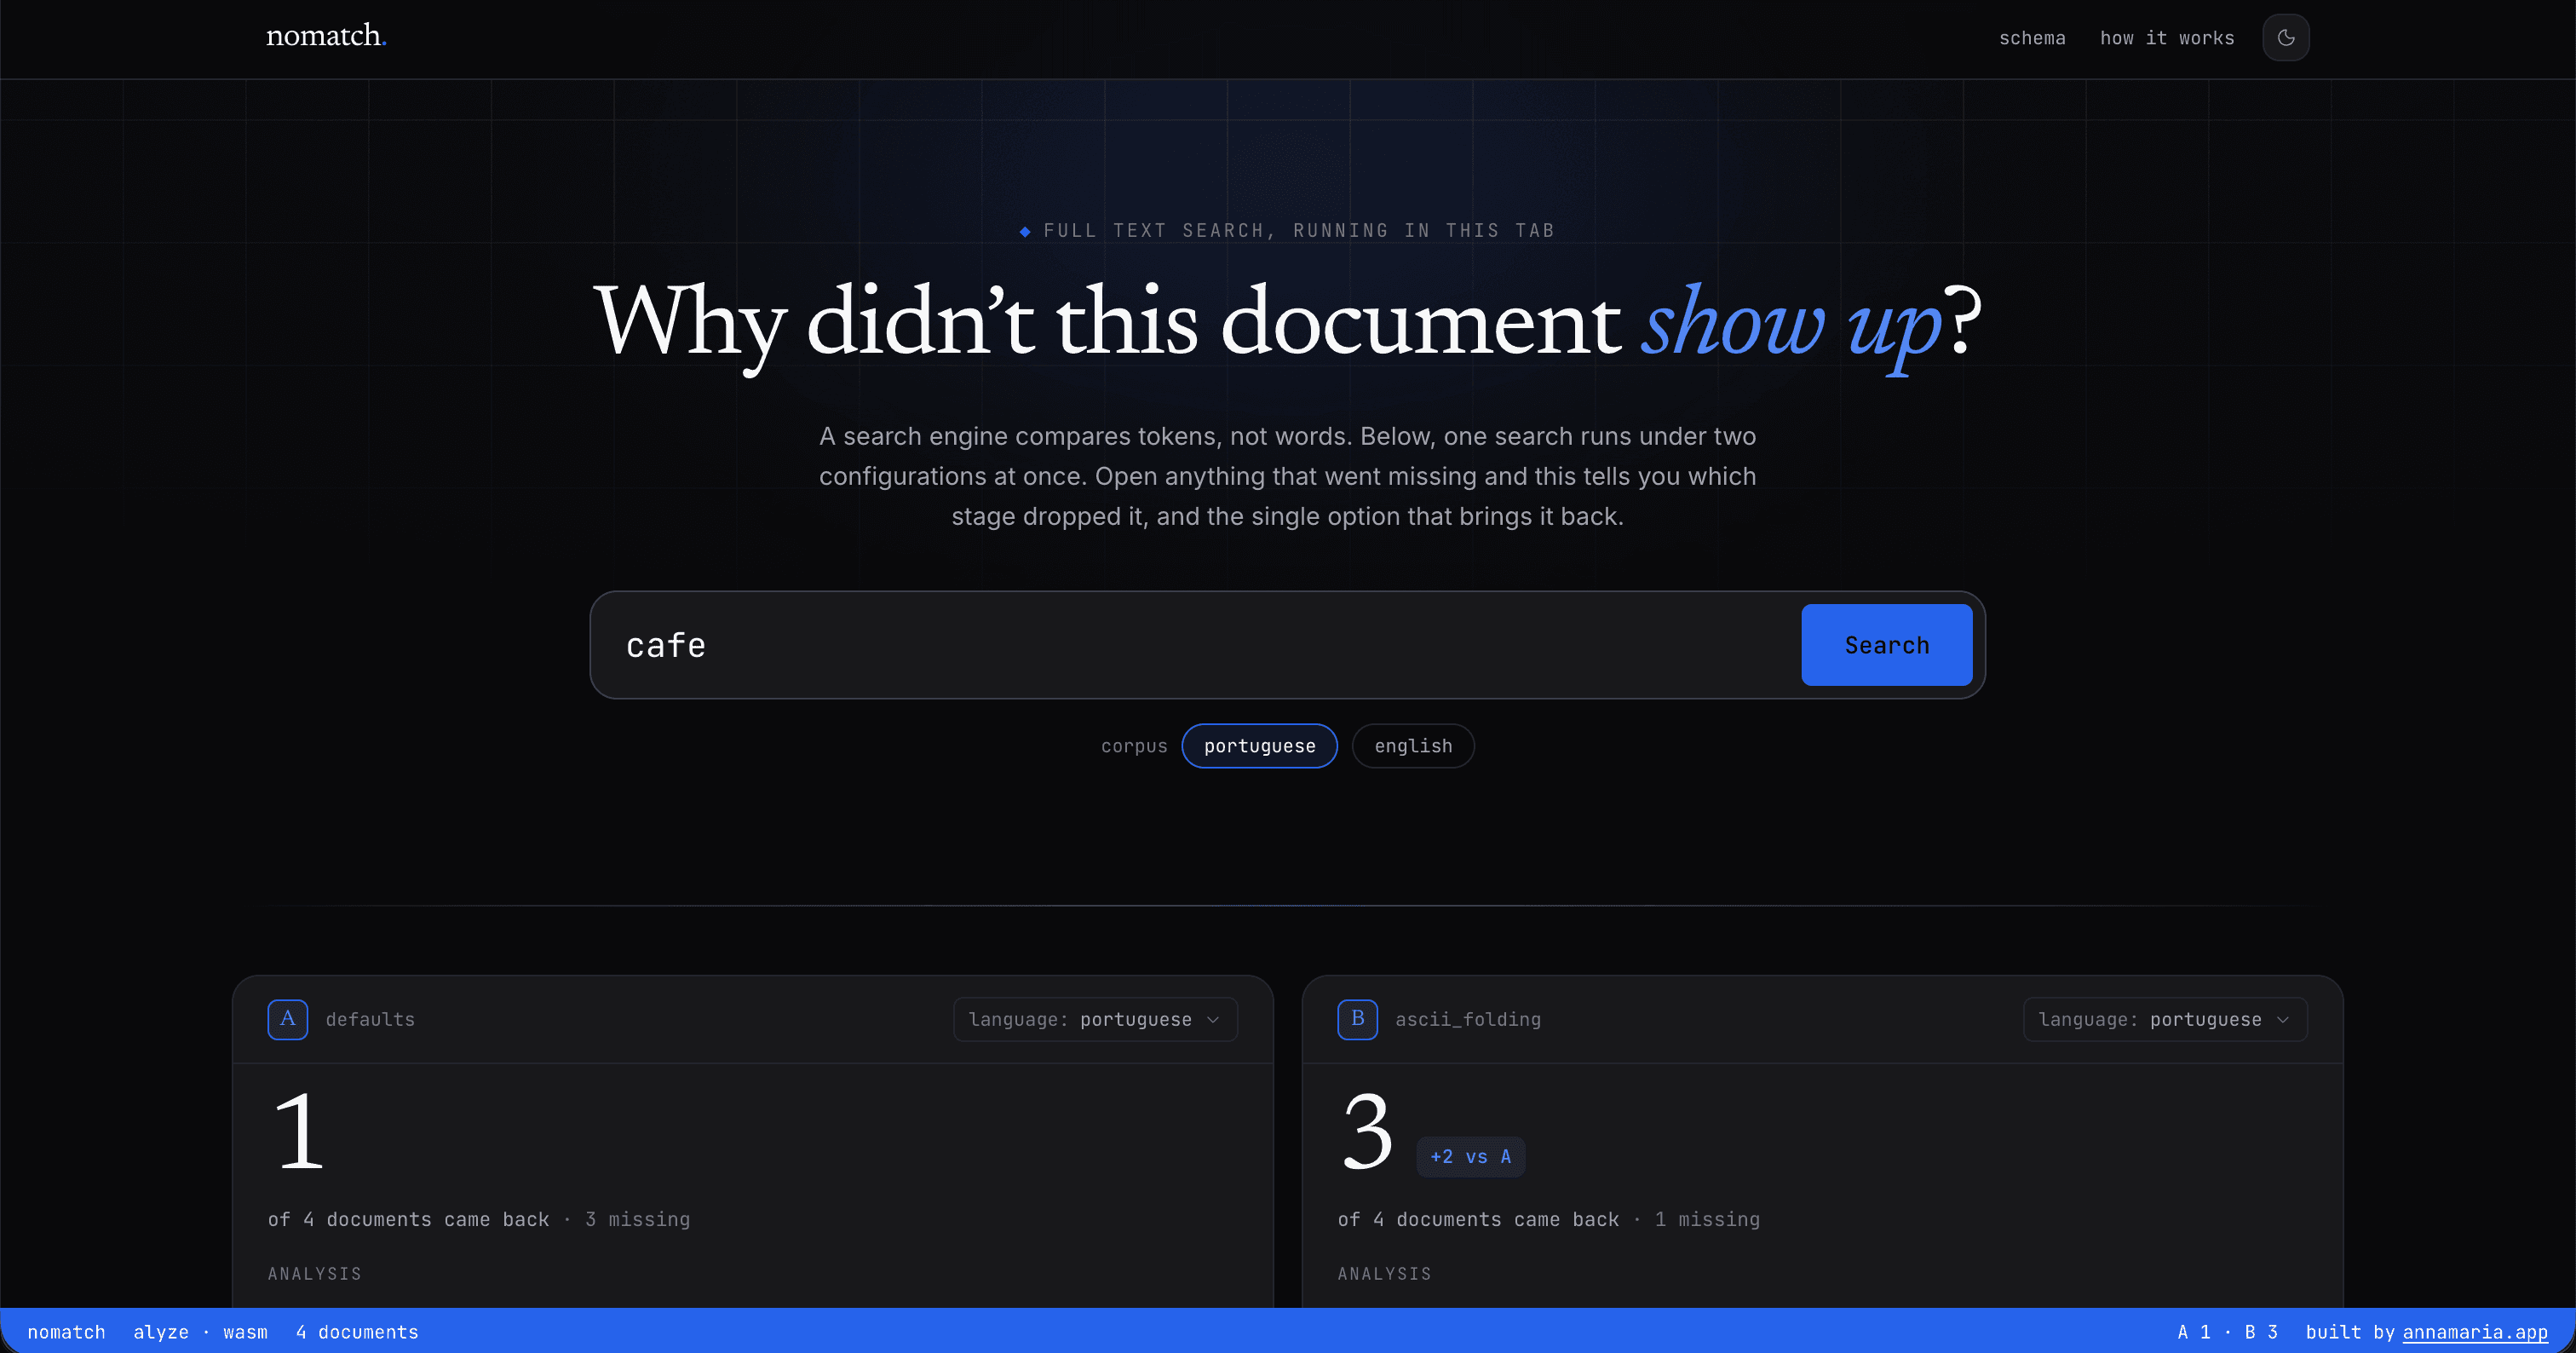
Cole um texto, digite uma busca, e veja quais documentos voltam em duas configurações de tokenizer ao mesmo tempo. Pros que não voltaram, o nomatch diz qual etapa do pipeline de análise derrubou cada um, e a única opção que traz ele de volta.
Ele roda em cima do alyze, a biblioteca de tokenização
que a turbopuffer usa em produção por trás do tokenizer word_v4,
compilada pra WebAssembly e hospedada num Web Worker. Sem servidor, sem conta, sem chamada de
rede pro produto de ninguém. Nada do que você cola sai da aba.
Não tem uma conta da turbopuffer por trás disso, e o projeto não é afiliado a eles. O motor de
análise é o alyze de verdade, licença MIT, compilado do commit 1de437c. O ranking BM25 é meu,
escrito pra esse projeto. Ele segue o significado documentado de k1, b e k3, mas não é o
código deles nem uma referência de como o ranking deles se comporta em produção.
Eu construí pra entender como um motor de busca decide o que volta, num nível em que eu conseguisse reconstruir sozinha a parte que decide. Colocar um app Next no ar não é o teste. A camada de busca embaixo dele é.
O problema que ele resolve
Um motor de busca não guarda o seu texto. Ele corta o texto em pedaços chamados tokens e guarda os pedaços. Quando você busca, ele corta a sua busca do mesmo jeito e compara pedaço com pedaço. Só existe match quando dois tokens são exatamente iguais.
Documento guardado: O café da manhã estava ótimo. Sua busca: cafe.
Com ascii_folding desligado, que é o padrão, o documento tem café, a busca vira cafe, e
não volta nada. O documento está lá. A palavra está lá.
Hoje você descobre isso pagando por uma conta, subindo os seus dados, buscando, não achando nada, e depois chutando qual das cinco opções foi a culpada, uma de cada vez.
Em inglês isso quase nunca acontece, porque inglês não tem acento. Aparece no momento em que você indexa português, francês, alemão ou espanhol. Foi por isso que eu construí, e é por isso que o corpus padrão está em português.
A escada de etapas
O alyze devolve o resultado final da análise, não os passos que ele deu. Pra achar qual passo matou um match, o nomatch roda o analisador várias vezes, com as opções ligando em cascata, e depois compara as saídas.
S0  tokenize only            case_sensitive: true
S1  + lowercase              case_sensitive: false
S2  + remove stopwords       remove_stopwords: true
S3  + stemming               stemming: true
S4  + ascii folding          ascii_folding: true
Stemming e remoção de stopwords só aparecem a partir de S1, porque os dois exigem
case_sensitive: false.
Pra uma palavra da busca contra uma palavra do documento, a escada acompanha dois índices: a primeira etapa em que os dois lados estão vivos e textualmente iguais, e a primeira etapa em que a palavra do documento passa de viva pra descartada. A primeira vem sempre antes da segunda, por construção, porque um token descartado nunca é igual a nada. Isso dá três veredictos, e não existe um quarto:
- convergiu em alguma etapa, então o match precisa da opção daquela etapa ligada
- sumiu em alguma etapa, então foi aquela etapa que descartou, e no caso de uma stopword a interface diz qual é a palavra
- nunca, o que significa palavras diferentes, não um problema de configuração
O max_token_length fica fora da escada. Ele é conferido em bytes e relatado à parte, porque
um documento pode ao mesmo tempo não ter nenhuma palavra perto da busca e, separadamente, ter
um termo de busca comprido demais pra virar token.
O que ele prova
A escada é o produto. O resto existe pra tornar ela possível, e cada peça está ali pra impedir uma falha específica:
- A recomendação aponta a opção mais estreita que resolve, não a etapa em que a cascata
para. A cascata é cumulativa, então ela só consegue dizer qual prefixo do pipeline deixa
duas palavras iguais. Com
language: portuguese, o stemmer Snowball tira a vogal final tanto decafequanto decafé, então a cascata converge no stemming, uma etapa antes do folding. A escada estava falando a verdade e dando um conselho ruim: stemming junta famílias inteiras de palavras num corpus,ascii_foldingsó mexe em acento. Agora ela pergunta pro analisador quais opções sozinhas fecham a diferença de verdade, e prefere a mais estreita. - Um documento removido por frase exata recebe uma resposta própria, decidida fora da escada. Um documento pode ter todas as palavras da busca e mesmo assim ficar de fora, porque a ordem da frase tirou ele. A escada não enxerga isso, e sozinha ela relata cinco etapas de match num documento listado como ausente. Só o matcher tem os dois resultados sobre os mesmos tokens, então é ele que sinaliza o caso, em vez de deixar a escada adivinhar.
- Uma busca que a análise reduz a zero tokens é pega antes de qualquer coisa rodar. Buscar
dacomremove_stopwordsligado elanguage: portuguesenão é "nenhum documento encontrado", é não ter nada pra comparar com nada, e a interface diz isso com todas as letras. - O ranking nunca chega no analisador. Medido no navegador contando
postMessage: uma busca no corpus de exemplo custa cinco chamadas, uma pra busca e uma por documento. Mexer emk1,bouk3depois custa zero, e a ordem ainda muda na tela. - As posições mantêm os buracos. Toda palavra gasta uma posição mesmo quando um filtro joga ela fora, e é isso que mantém a distância de frase correta. A visualização de tokens desenha os buracos em vez de esconder, e o match de frase compara diferenças de posição em vez de índices do array, então uma stopword descartada igual nos dois lados não quebra uma frase, mas uma palavra de verdade entre os termos quebra.
Um achado que eu deixei quieto
Buscar manha contra um documento que tem manhã, em português, é classificado como nunca.
O stemmer tira a vogal final de manha mas deixa manhã intacta, porque o acento faz ela não
casar mais com a mesma regra de sufixo. O ascii_folding roda depois do stemming, então quando
manhã vira manha, a busca já foi reduzida pra manh. Elas nunca convergem.
Duas formas do que uma pessoa chamaria de a mesma palavra, que acabam inalcançáveis por causa
da ordem do pipeline, e não porque tem alguma coisa errada. A escada está relatando o pipeline
com honestidade, então fica. O caso de teste de stemming usa correr e correu em vez de um
par com acento, justamente pra esse teste não tropeçar nisso.
Reproduzindo o erro
A página abre com um corpus carregado e uma busca já feita, então o contraste está na tela
antes de você encostar em qualquer coisa. A coluna A são os padrões de verdade e acha um
documento. A coluna B tem ascii_folding ligado e acha três. Os dois a mais escrevem café
com acento.
Clique em qualquer documento em missing pra abrir a escada dele, e o botão no fim do painel
aplica a correção na outra coluna e fecha a gaveta. Isso é uma ferramenta de comparação,
então o trabalho do botão é montar a comparação que prova a correção, não alterar aquilo que
você estava lendo. O 0 que mostrava o problema continua na tela, ao lado da contagem que
prova a correção.
Troque o corpus pra inglês e a mesma falha fica quase invisível, e é pra isso que ele está lá.
O que quebra ali é um plural: cafes não acha cafe até o stemming estar ligado. Então cada
corpus carrega a sua própria busca e a sua própria correção, e os dois abrem no mesmo contraste
por motivos diferentes.
Sobre o ranking
O BM25 decide a ordem dos documentos que já deram match, e nunca decide se um documento volta.
O k1 começa em 1.2, o b em 0.75 e o k3 em 8.0, iguais aos padrões documentados da
turbopuffer, e os três são ajustáveis por coluna.
Duas decisões que vale nomear:
- O IDF é a forma suavizada,
ln(1 + (N - n + 0.5) / (n + 0.5)). A forma do livro põe o 1 fora do log e fica negativa assim que um termo aparece em mais da metade dos documentos. Em corpus de cinco frases coladas isso não é um caso raro, é uma terça-feira, e uma nota negativa na tela custa mais confiança do que a precisão compra. - O tamanho do documento são os tokens que sobreviveram à análise, não as posições gastas. Um documento não é mais comprido, em nenhum sentido que importe pro ranking, porque por acaso tinha stopwords que foram removidas antes de indexar. Os buracos ainda importam e ainda existem, só não entram na média.
Stack
- Next.js e TypeScript, Tailwind v4, entrepta no tema
bosco - alyze compilado pra WASM com
wasm-pack --target web, commitado empublic/wasm/e servido por URL em vez de passar pelo bundler - Um Web Worker em ES module hospedando o módulo, porque rodar a escada num corpus na thread principal trava ela
- BM25 em TypeScript, em cima dos tokens que o analisador devolve
O build completo traz as 18 línguas de stemming em 392 KB sem compressão, então não tinha nada pra ganhar cortando alguma. O seletor de língua oferece português e inglês, e isso é uma restrição da interface, não do que foi compilado.
Rodando local
Tem uma demo no ar no link acima. Pra rodar local:
npm install
npm run dev
Abre em localhost:3000. O artefato WASM compilado está commitado, então você não precisa de
Rust pra rodar o app. Compilar do código-fonte é outro trabalho, documentado no CLAUDE.md.
Testes
O Vitest cobre o que quebra em silêncio: a escada contra casos conhecidos (um acento, uma stopword em português, uma raiz de stemming, um token acima do limite de bytes), contagem de bytes contra contagem de caracteres em texto com acento, o BM25 contra números calculados na mão antes de o código existir, e combinações inválidas de opções barradas antes de chegarem no analisador.
O caminho de ponta a ponta, do WASM ao worker ao match, é coberto por um smoke test de Playwright contra o app rodando, e não pela suíte unitária. O Vitest testa a lógica; o smoke test prova que o pipeline está ligado de verdade, em dev e num build real de produção. O build é metade do teste, porque o worker e o módulo WASM quebram exatamente na passagem entre os dois.
Toda afirmação que a interface faz tem um teste por trás, e os testes falham quando a afirmação deixa de ser verdade.
Licença
MIT. O alyze também é MIT, e o copyright dele continua sendo da turbopuffer.